# 一、一条消息经过Kafka的过程
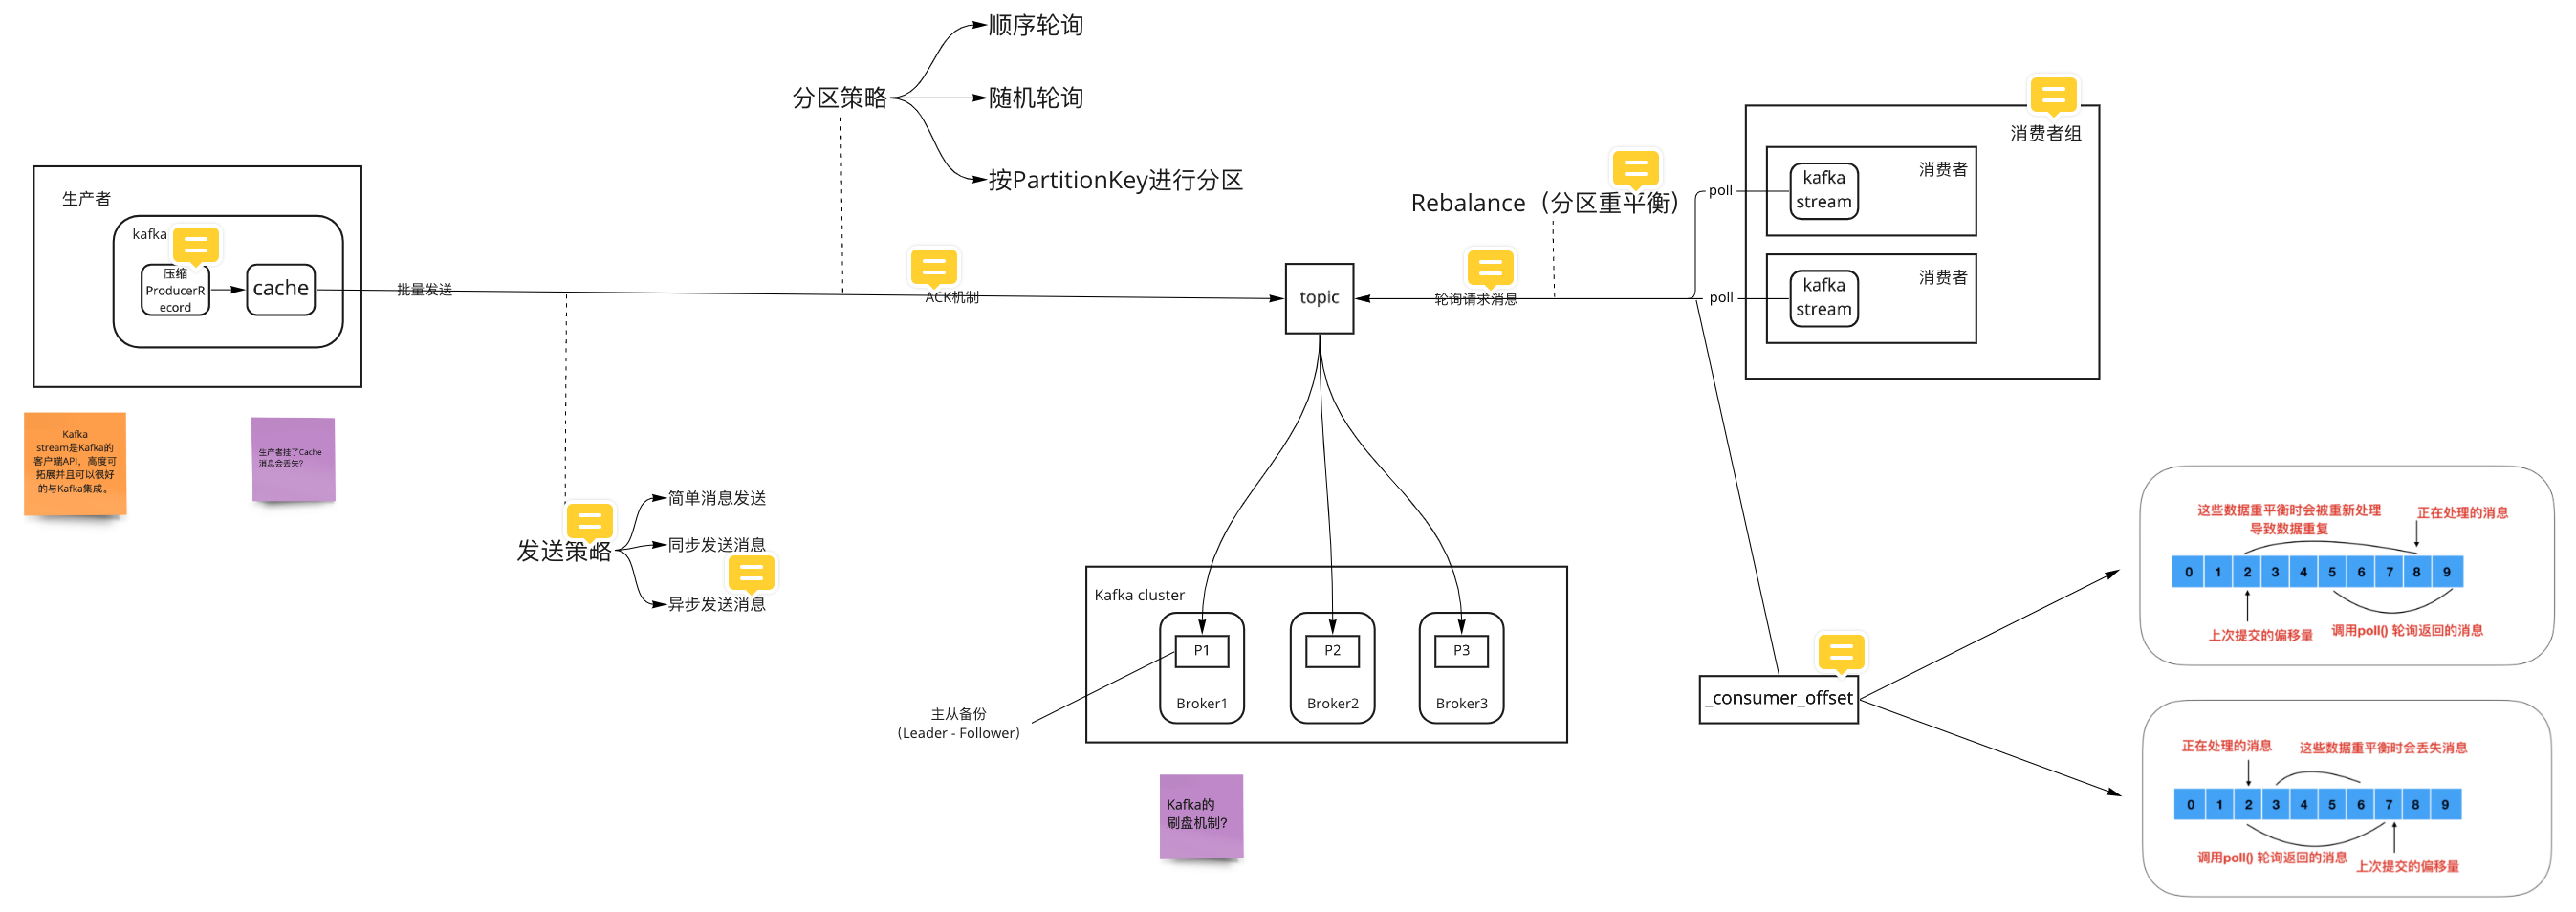
Kafka本质上是一个消息队列,最简单的消息发送过程为:生产者 -> Kafka -> 消费者,而针对不同的应用场景,可以配置不同的发送策略、分区策略、消费策略等。这里主要以Kafka默认配置下的发送过程进行分析。
生产者端:
消息压缩:生产者生成消息并对消息进行压缩(通过
compression.type参数配置,支持GZIP、Snappy 和 LZ4,2.1.0后支持Facebook开源的Zstandard压缩算法。)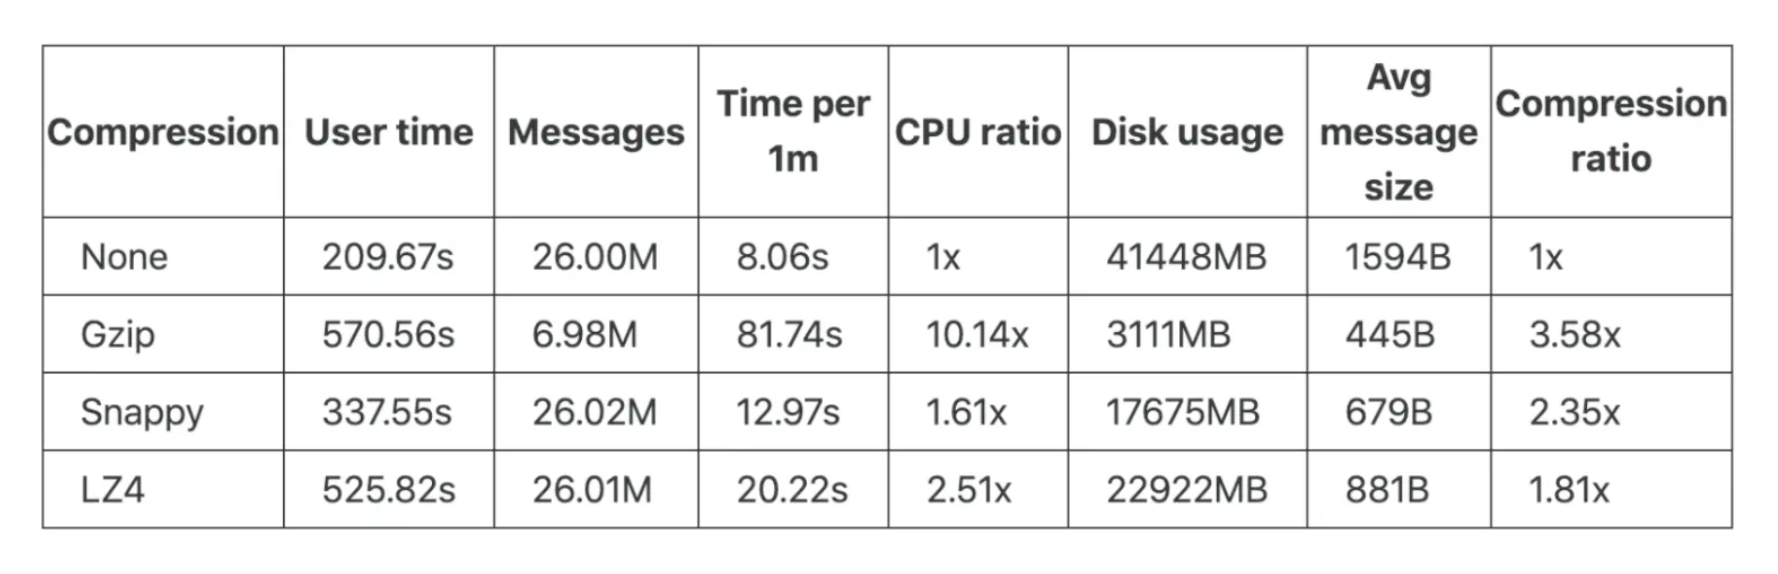
批量发送:生产者会将多条消息存放在cache中,达到一定数量再进行批量发送到指定Topic,减少RTT时间。
发送策略:Kafka默认采用简单消息发送,不保证消息不丢失
Kafka:
- Broker定位:消息到达Kafka后,需要到Zookeeper查找对应Topic的Partition所在的Broker地址。
- 分区策略:Kafka默认采用顺序轮询的策略,接收到生产者的消息后,将消息顺序分配到查到的partition(Leader)所在的Broker,并以磁盘顺序写入的方式将消息持久化到文件。
- 主从备份:Leader节点将消息同步到Flower节点进行备份
消息者端:
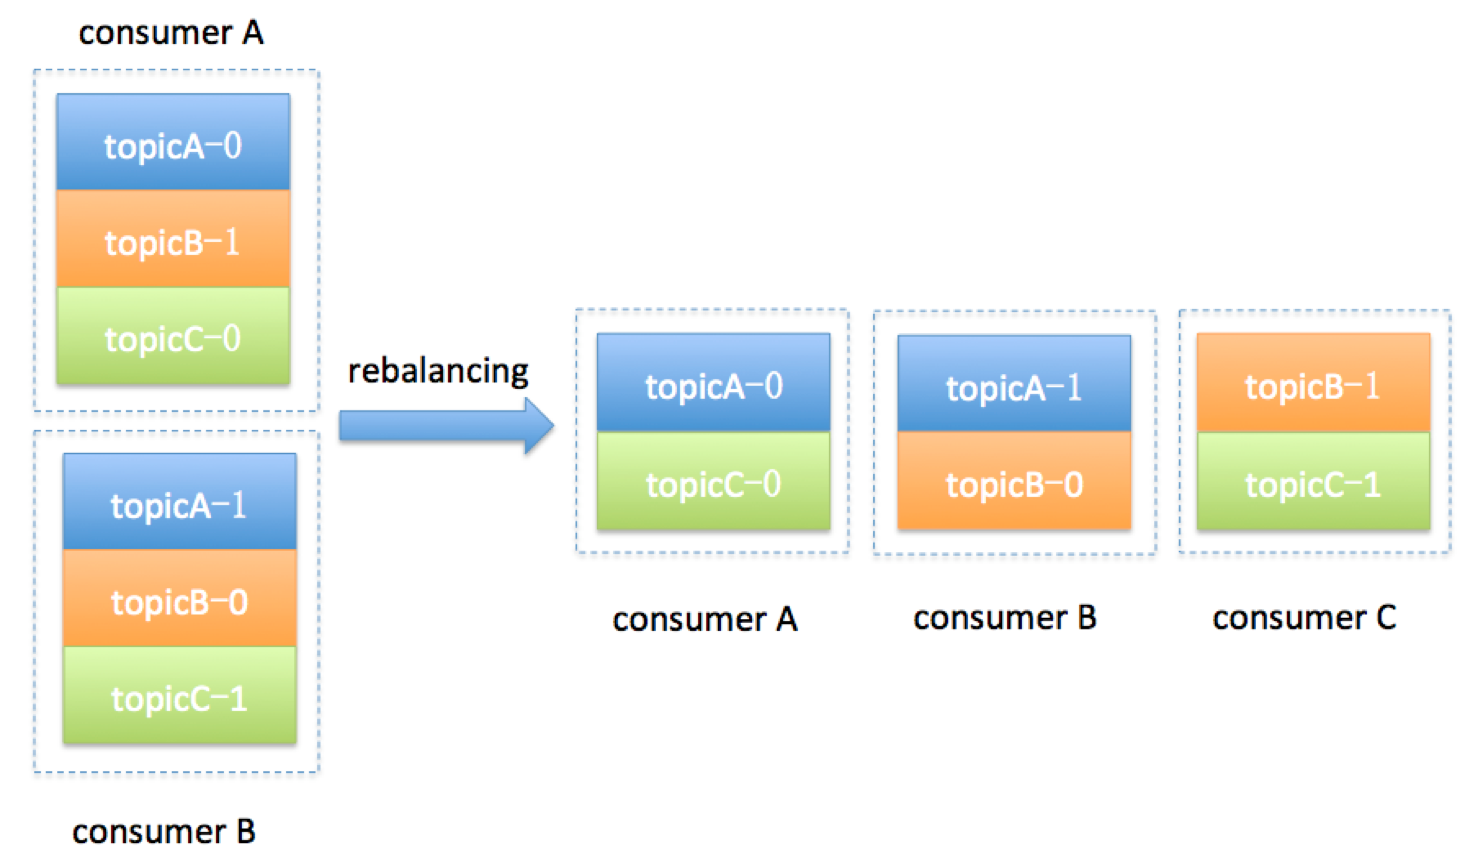
- (分区平衡):消费者以组的方式存在,消费同一个Topic的消费者被归为一组,每个消费者可以消费一到多个Partition,每个Partition至少被一个消费者消费。当有新的消费者加入时,会触发Reblance,将Partition对应的消费者进行重新分配。理想情况下,消费者组中的实例数量应该等于Partition数量。
Reblance的三个条件
- 消费者组实例变化
- 订阅的主题变化
- 主题下的分区变化
由于Reblance会导致STW,所以应该尽可能避免Reblance的发生。
- Poll消息:Kafka默认采用“拉”的方式,即消费者批量拉取消息进行消费,并且将offset(位移)进行提交。
offset的存储
早期的Offset统一存放在Zookeeper中,但是后面实践证明这种做法是不合适的,因为Zookeeper不适合做频繁的写操作,而Offset的写操作是很频繁的,后来Offset以内部主题的方式进行存储,即存放在默认主题
__consumer_offsets中。该内部主题在第一个Consumer启动的时候就自动创建,该主题的默认分区数是 50,副本数是 3。__consumer_offsets主题存在以下内容:
- Consumer group组元数据消息
- Consumer group位移消息
- Consumer group删除消息(delete mark):消费组无实例存活,并且对应的offset都被删除,则发送删除该组的消息
offset的数据结构
Offset是相对于消费者组而言的,用于记录当前消费者组对应Topic下的Partition消费的位置,数据结构可以简单的理解为KV结构,即类似
Map<三元组, 位移>,三元组为:<groupId + topic + 分区号>,每个消费者组都有对应这样类似数据结构的Map。
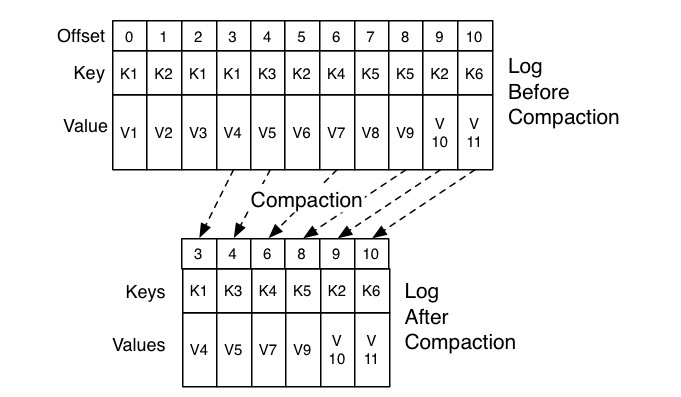
- offset提交策略:Kafka默认采用自动提交策略,即消费者端会定时提交对应分区端Offset(Kafka集成的大数据框架都是默认关闭的,例如Spark、Flink等),而自动提交会导致offset主题有大量消息,为了进行清除,Kafka提供了专门的后台线程(log cleaner)定期清除过期的offset消息,可以认为是进行了压缩整理,跟Redis的AOF重新写入类似。
- (并发消费):为了提高吞吐量,可以在消费者端自行创建多个queue,并将消息根据key进行哈希取模处理,分配到不同的queue下利用多线程并行处理。
# 二、基础架构
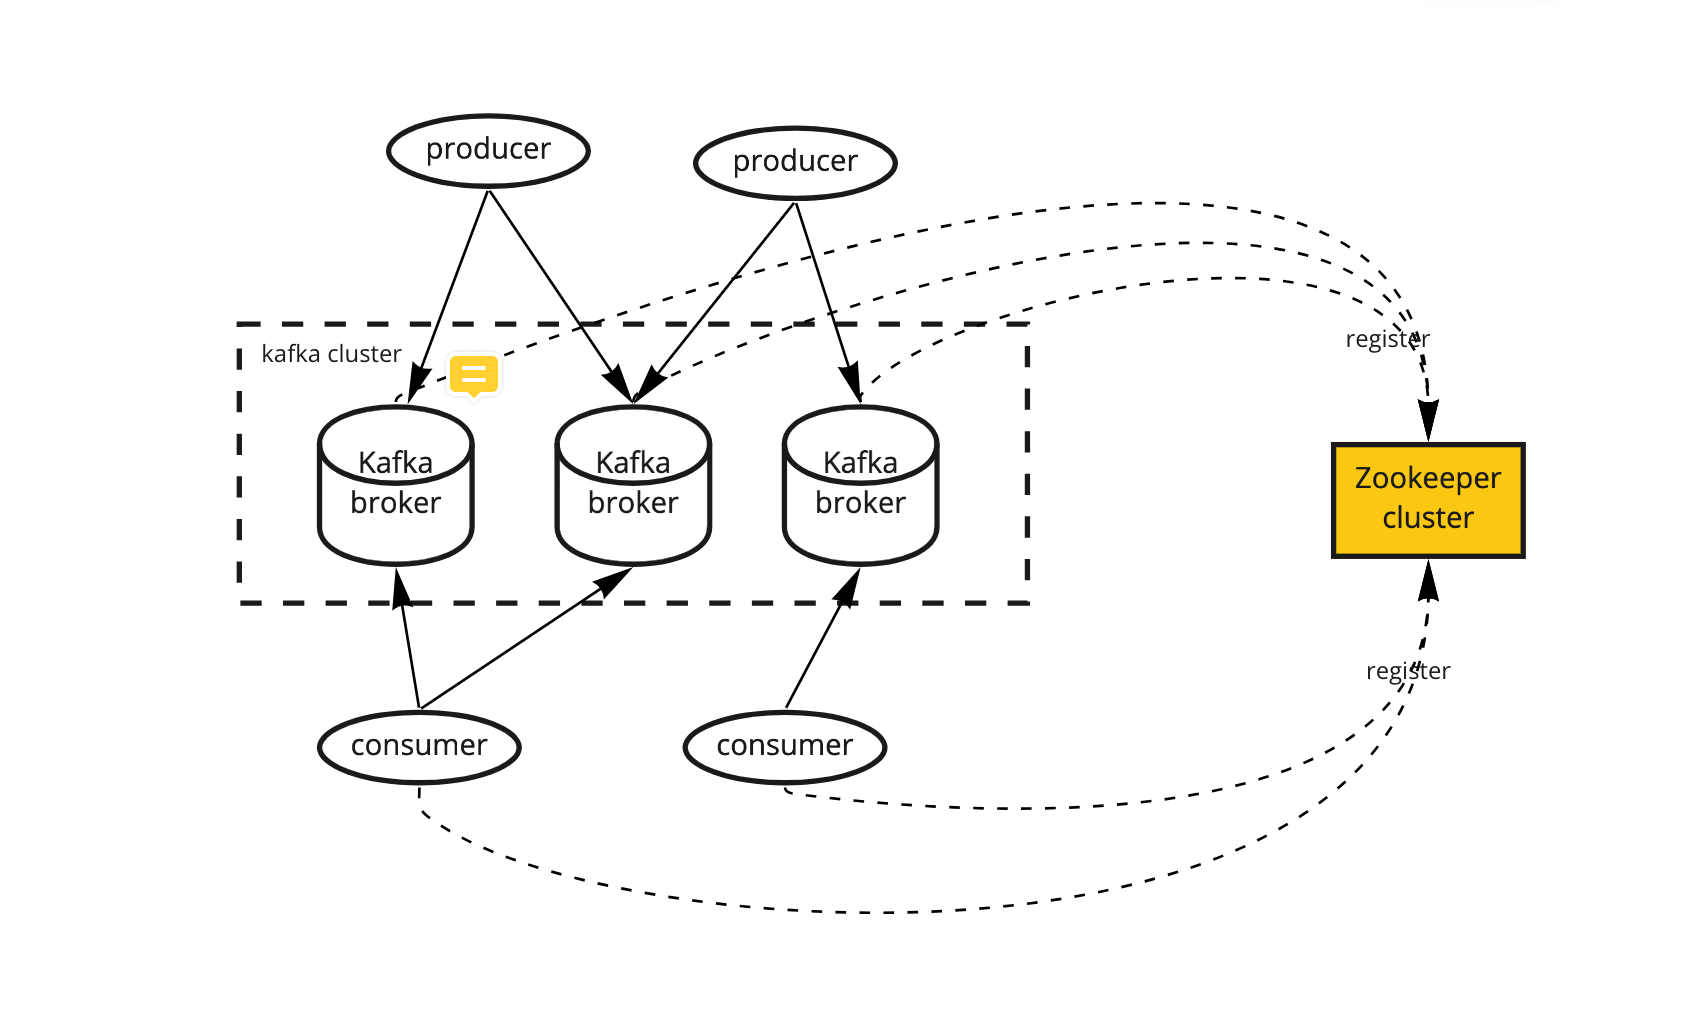
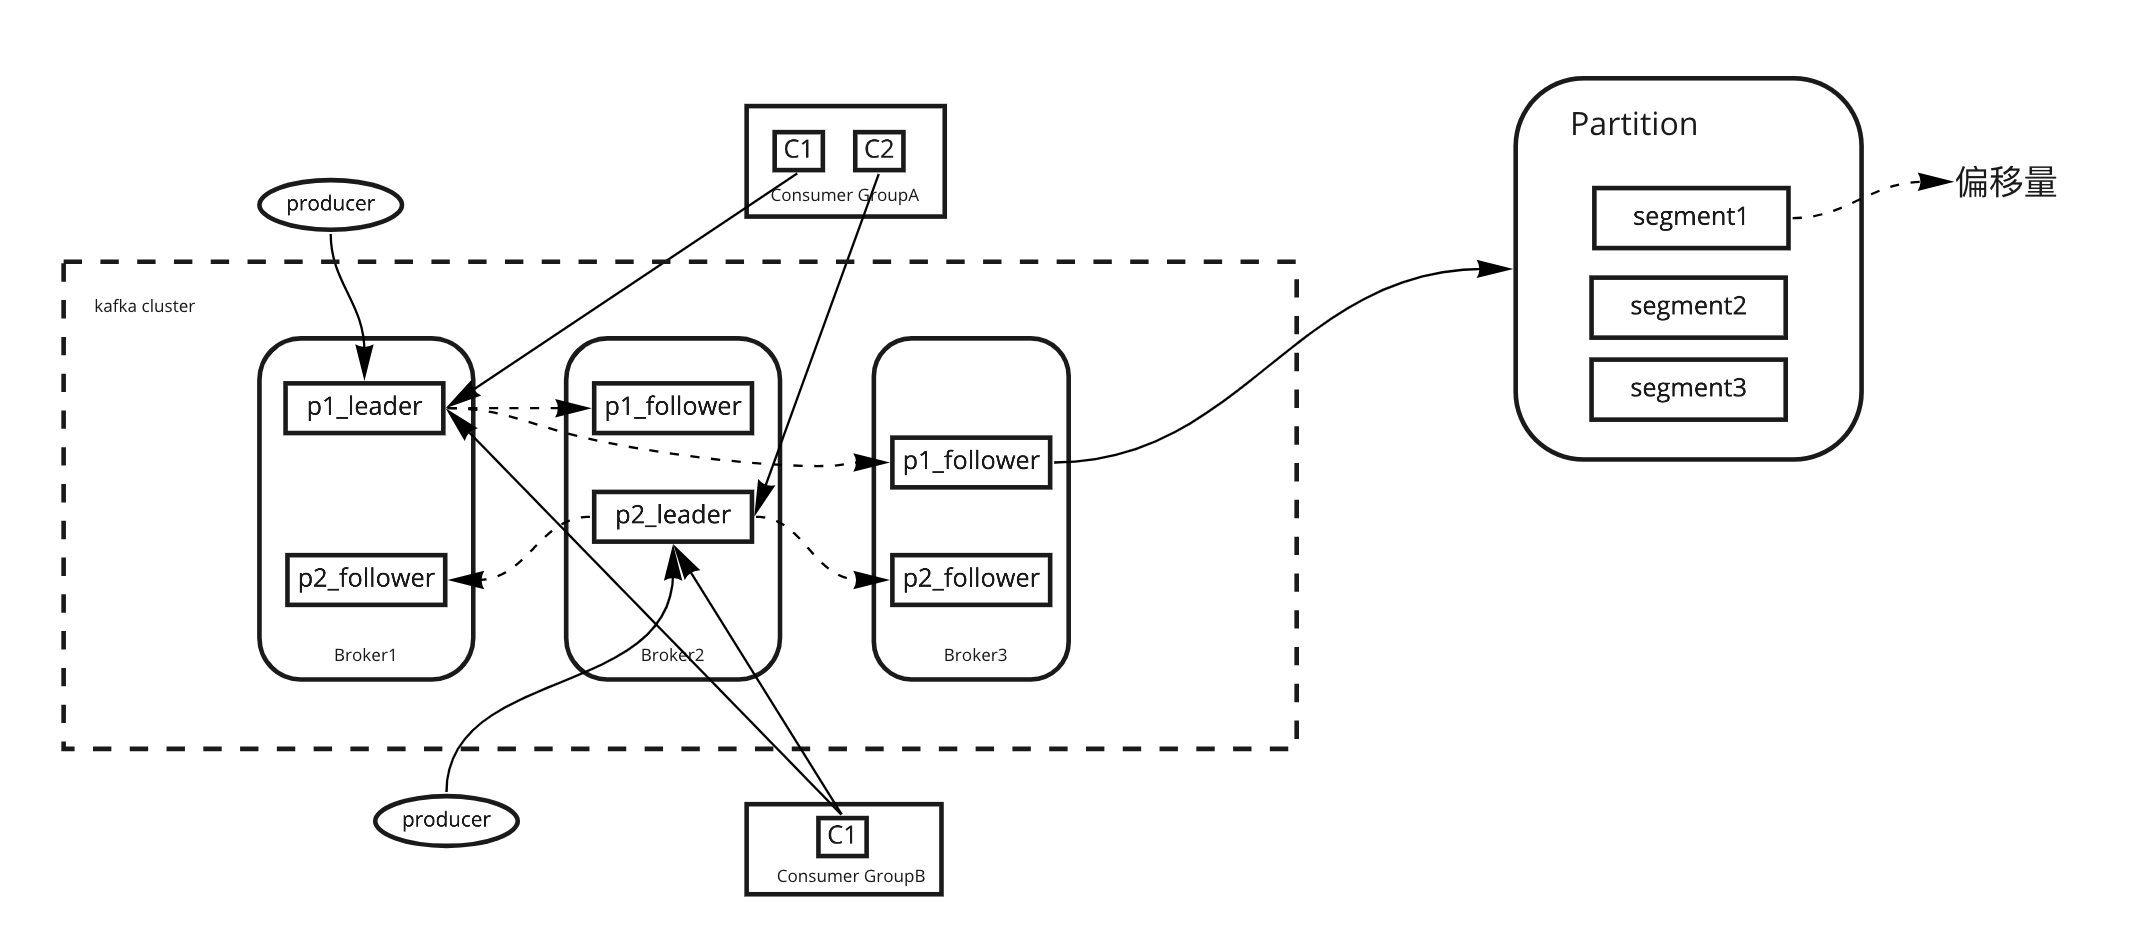
# 三、核心组件
# Zookeeper
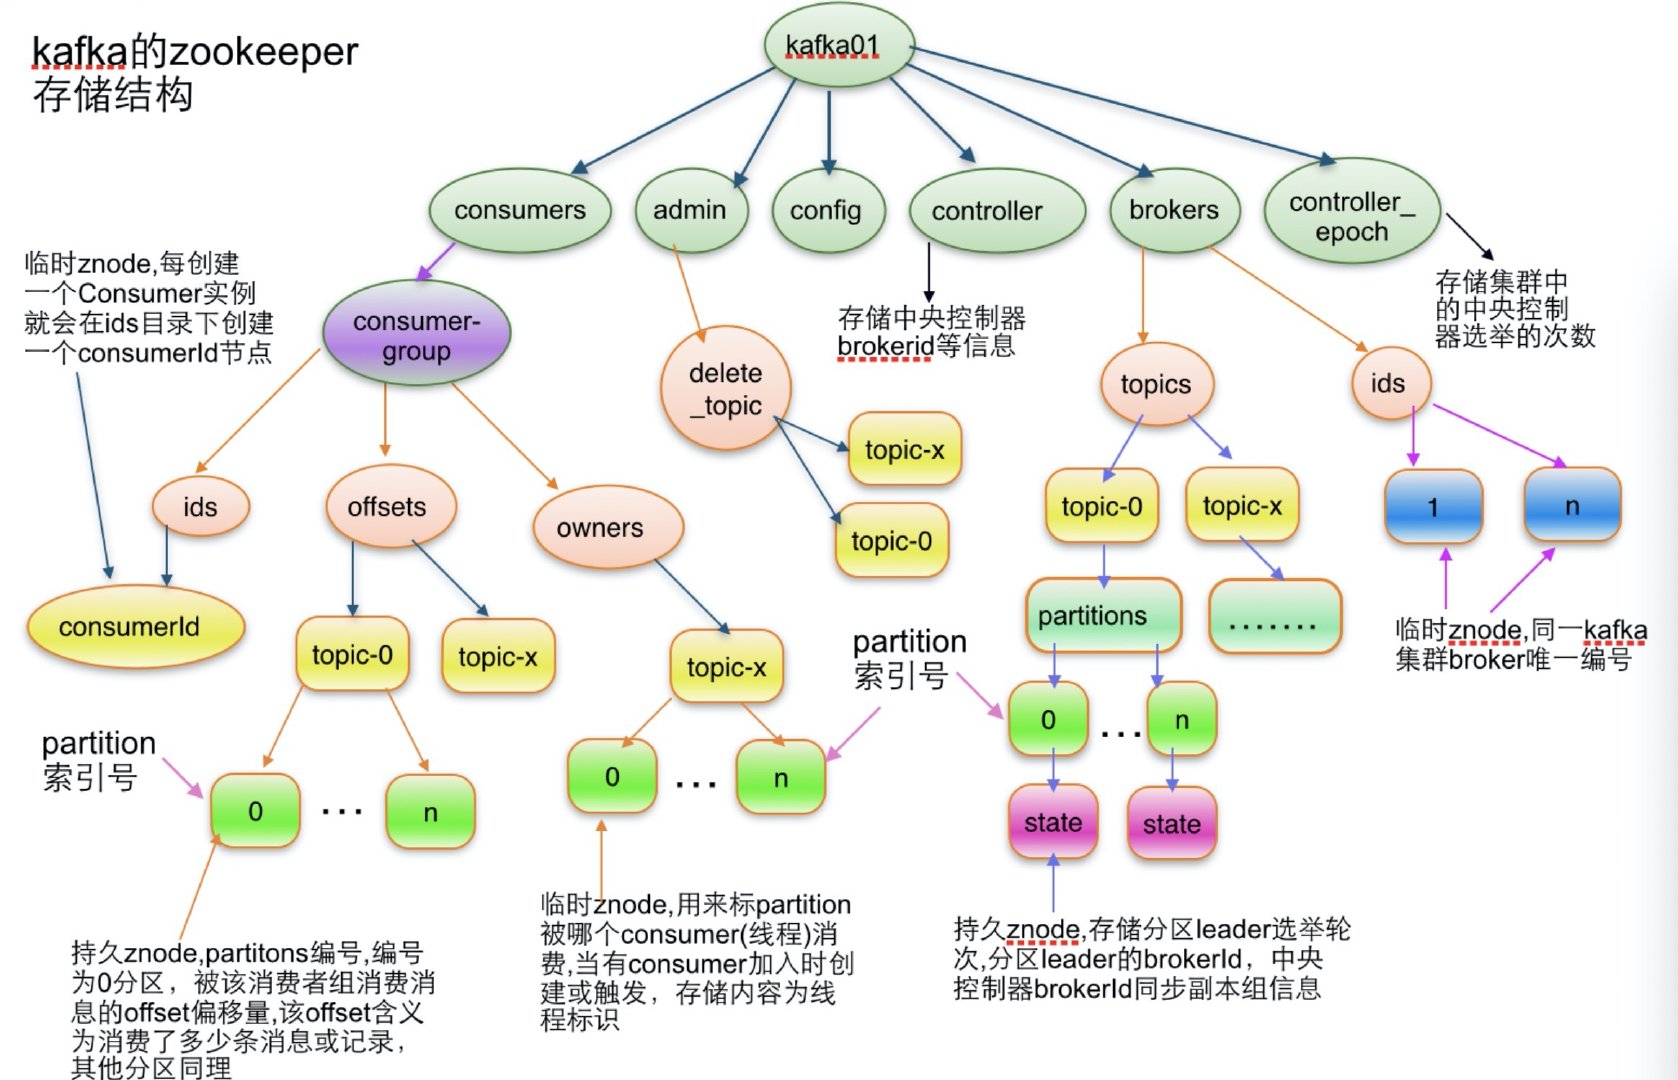
Zookeeper是一个分布式协调框架,底层采用树状结构存储,类似于Linux的目录结构,其中每个节点称为ZNode(分为临时节点和持久节点两类)。其特点就是树状存储及watches功能,client可以通过watches可以监听某个znode,当该节点变化时会通知到对应的client。Zookeeper的应用场景通常有以下几种:
- 集中式元数据管理(KV存储,基于其树型结构)
- 分布式锁(分布式同步服务,通过其原子性发号器)
- 分布式选举(ZAB协议)
在Kafka中,Zookeeper主要有以下功能:
- 元数据存储
- Broker节点信息(注册、注销、属性变更,内容包括ip,端口等)
- Topic信息(Topic对应的Partition分区)
Partition分区的offset信息(早期版本存储,后来迁移到了Kafka内部主题)- Controller选举
- 存储当前Controller信息(Controller Broker id,当前的Controller年龄epoch(用于防止脑裂))
- brokers目录
# 表示当前集群有3个节点
[zk: 127.0.0.1:2181(CONNECTED) 6] ls /kafka/brokers/ids
[1, 2, 3]

# broker详情
[zk: 127.0.0.1:2181(CONNECTED) 10] get  /kafka/brokers/ids/1
{"listener_security_protocol_map":{"PLAINTEXT":"PLAINTEXT"},"endpoints":["PLAINTEXT://10.0.0.1:9092"],"jmx_port":9999,"host":"10.0.0.1","timestamp":"1588925944886","port":9092,"version":4}

# topic详情(Topic对应的Partition信息)
[zk: 127.0.0.1:2181(CONNECTED) 11] get  /kafka/brokers/topics/__consumer_offsets
{"version":2,"partitions":{"1":[2,1,3],"0":[3,2,1],"2":[1,2,3],"adding_replicas":{},"removing_replicas":{}}
2
3
4
5
6
7
8
9
10
11
12
- controller目录
# 可以看到当前broker-1为集群的controller节点
[zk: 127.0.0.1:2181(CONNECTED) 30] get  /kafka/controller
{"version":1,"brokerid":1,"timestamp":"1588833869354"}
2
3
- controller_epoch 目录结构
# 可以看到controller的年龄是2,说明controller经历过2次变更了
[zk: 127.0.0.1:2181(CONNECTED) 32] get  /kafka/controller_epoch
2
2
3
# Broker
Broker对应到具体的物理机,可以认为每台物理机即为一个Broker,一个Broker可以存放多个Partition。
# Topic
Topic即主题,通常会对应到我们业务数据,Topic可以认为是一种业务数据的抽象,表示该Topic存放的是什么类型的消息。
# Partition
Partition即分区,在磁盘上就体现为一个目录。一个Topic下可以有多个Partition,不同partition可以被存储在不同的Broker,Partition又分为Leader和Follower,Leader用于对外提供写入和读取操作,Follower用于备份(通常Follower通常分布在不同的Broker上)。Kafka就是利用Partition提高其吞吐量,因为Partition可以被消费者并行消费,大大提高消费性能。
# Controller
Controller是kafka中一个特殊的Broker,一个集群中只有一个,它的特点是需要做其他额外的工作:
- 集群Broker管理(新增 Broker、Broker 主动关闭、Broker 故障)
- 主题管理:创建、删除主题,增加分区并分配leader分区
- 分区管理:
- ISR(in-sync replica,同步副本列表)管理
- Leader选举
- 分区重分配(Reblance)